Informatica e IAIntelligenza artificiale
IA a casa: riprendere il controllo dei tuoi dati
· Michel Aguilera
Lettura: 8 min · Per i curiosi, i principianti e gli appassionati di digitale
Quando fai una domanda a un assistente AI online, il tuo testo arriva ai server di un’azienda, da qualche parte nel mondo. Comodo, ma non sempre sai cosa succede. E se l’IA fosse in esecuzione a casa, sul tuo computer o su un piccolo server nel tuo ufficio? Questo si chiama IA locale. La buona notizia è che è molto più accessibile di quanto si pensi.
Perché tutti parlano di mantenere il controllo dei propri dati
Immagina di affidare i tuoi documenti a una segreteria esterna. Fa un ottimo lavoro, ma i tuoi file escono dal tuo ufficio. Con l’IA online, è un po’ la stessa cosa: le tue domande, i tuoi file e le tue idee passano attraverso i server di un fornitore.
Sempre più persone e aziende vogliono sapere esattamente cosa vede e usa l’IA. Due approcci rispondono a questa esigenza:
- On-locali : L’IA gira interamente sul tuo hardware. Non ne esce nulla.
- Ibrido : compiti semplici o sensibili restano sulla tua macchina, e solo i compiti molto pesanti vanno nel cloud (i grandi server online).
L’approccio ibrido è un po’ come cucinare a casa ogni giorno e andare al ristorante per occasioni speciali. Per molti, questa è l’opzione preferita.
Microsoft punta anche sull’“intelligenza ibrida”
Non sono l’unico a pensarla così. Il 7 ottobre 2026, Microsoft ha presentato la sua visione di un Windows costruito per l’“intelligenza ibrida”. Nel suo post, Pavan Davuluri, responsabile del Windows, spiega che gli agenti AI potranno eseguire localmente quando rilevante e utilizzare il cloud quando necessario, grazie all’instradamento automatico delle task.
Cosa devi ricordare:
- Copilot su Windows, con il tuo permesso, potrà utilizzare il contesto del tuo PC (i tuoi file, la tua attività recente), agire per te e fare affidamento su modelli di IA installati localmente. Queste funzionalità dovrebbero arrivare nei prossimi mesi.
- I Microsoft Execution Container (MXC) sono disponibili ora dall’11 Windows . Si tratta di una sorta di “sandbox” che definiscono a quali file e reti un agente AI può accedere.
- Stanno arrivando nuovi PC progettati per eseguire l’IA localmente, come il Surface Laptop Ultra con chip NVIDIA RTX Spark.
In altre parole, persino il colosso di Redmond ammette che inviare tutto nel cloud non è sempre la scelta migliore. Presentazione ufficiale di Microsoft:
Per andare oltre, due video (in inglese) di creatori che analizzano questi annunci:
Fonte: Costruire Windows per l’intelligenza ibrida, Windows Experience Blog
Partenza semplice: Ollama e Open WebUI
Non serve essere un informatico per provare l’IA localmente. Due strumenti gratuiti fanno la maggior parte del lavoro:
- Ollama : è il “motore”. Scarica ed esegue modelli di IA (chiamati LLM, per grandi modelli di linguaggio : programmi addestrati a comprendere e scrivere testo). Un comando, e il modello è pronto.
- Open WebUI : questo è il “bodywork”. Un’interfaccia web che sembra ChatGPT, ma che parla con i modelli installati in casa tua.
Il motore e la carrozzeria, in breve: uno fa il suo lavoro, l’altro lo rende piacevole da usare. E se vuoi anche creare immagini, Stable Diffusion è un’aggiunta facile al duo.
Ho realizzato un video in francese in cui vi mostro passo dopo passo l’installazione e la scoperta di questi strumenti:
Personalizza: NAS per connettori RAG e dati
Un modello AI è un po’ come un brillante stagista che ha letto tutto Internet… ma non i tuoi file. Non conosce i tuoi contratti, le tue procedure interne o le tue note. Ed è qui che entra in gioco il RAG.
Il RAG, spiegato in modo semplice
RAG sta per Retrieval-Augmented Generation. In termini concreti: prima di rispondere, l’IA cerca passaggi utili nei tuoi documenti, poi li usa per formulare la sua risposta. È come uno stagista che, prima di risponderti, va a consultare il raccoglitore giusto nell’armadietto.
Per rendere questa ricerca veloce, i tuoi documenti vengono tagliati in piccoli pezzi e memorizzati in un database vettoriale : una sorta di indice intelligente che trova i testi per significato, e non solo per parole esatte.
Perché un NAS?
Un NAS (Network Attached Storage) è una piccola scatola di archiviazione collegata alla tua rete, una sorta di hard disk condiviso per tutta la casa o l’ufficio. Molte persone già conservano lì i loro documenti. Quindi è l’armadietto ideale per RAG: i tuoi file restano a casa e l’IA viene a vederli sul posto. Open WebUI, ad esempio, ti permette di creare database di conoscenza dai tuoi documenti.
Connettori dati
Un connettore è un “pipe” che collega l’IA a una fonte di informazioni: un file NAS, un database, un account email, un calendario, ecc. Strumenti come n8n (un software di automazione in cui i blocchi vengono assemblati, senza programmazione) permettono di creare questi pipe. Ad esempio: “ogni volta che arriva un nuovo PDF in una cartella o quella, aggiungilo alla base di conoscenza dell’IA”. Scegli tu quali fonti collegare e quindi cosa l’IA può vedere.
Progetti open source tutto-in-uno, senza abbonamento
Montare ogni mattone da solo può sembrare scoraggiante. Per fortuna, la comunità open source (software con codice pubblico e libero) offre pacchetti pronti all’uso. Un buon esempio: Local AI Packaged, di Cole Medin.
Questo progetto installa un intero ambiente di intelligenza artificiale locale in una volta sola, grazie a Docker (uno strumento che esegue ogni software nella propria “scatola”, senza confondere tutto sul computer). Nel menu, secondo il suo README:
- Ollama per eseguire modelli di IA;
- Apri WebUI per chattare con loro;
- N8N per automazioni e connettori (oltre 400 integrazioni);
- Supabase per database, ricerca vettoriale e autenticazione;
- Qdrant e Neo4j per memorizzare e collegare la conoscenza;
- Flowise per costruire agenti senza codifica;
- SearXNG, un motore di ricerca web che non ti traccia;
- Langfuse per osservare cosa fanno gli agenti, e Caddy per garantire l’accesso tramite HTTPS.
Sono persino forniti esempi di feed RAG pronti all’importazione. Ecco come appare n8n in azione:
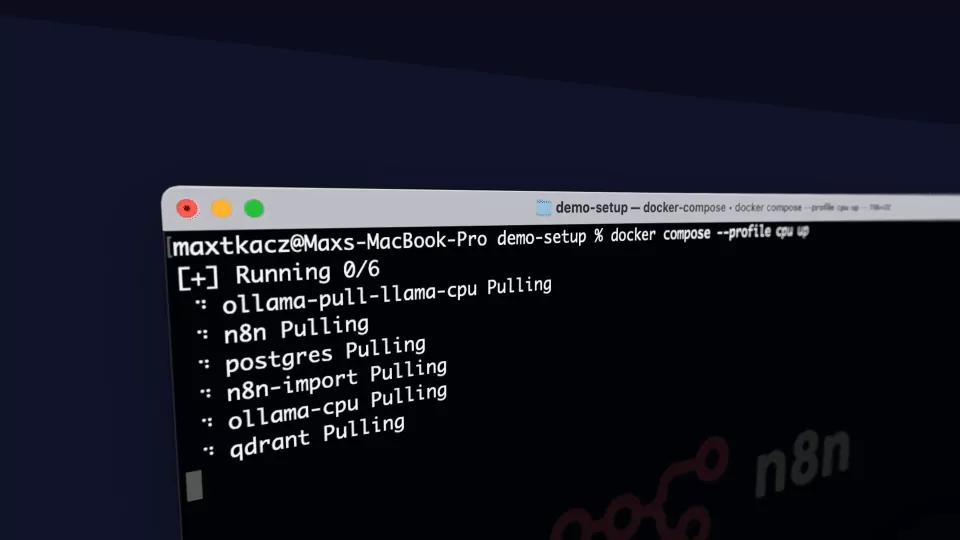
Tutto questo senza pagare un abbonamento: tutto ciò che serve è l’hardware… e un po’ di curiosità. Prerequisiti indicati: Python, Git e Docker.
Il nocciolo della questione: l’attrezzatura
Diciamoci la verità: l’IA locale significa una macchina leggermente muscolosa. Il componente chiave è la scheda grafica (GPU) e soprattutto la sua memoria video (VRAM). Pensa alla VRAM come a un piano di cucina: più è grande, più puoi preparare piatti grandi (modelli grandi) contemporaneamente.
Le cifre qui sotto sono indicative di ordini di grandezza ; tutto dipende dai modelli scelti.
Per uso individuale
- Per scoprire : un PC recente con 16 GB di RAM può eseguire modelli piccoli, anche senza una scheda grafica dedicata. Sarà lento, ma funziona.
- Per un uso comodo : una scheda grafica con 8-12 GB di VRAM, 32 GB di RAM e un SSD con spazio (un modello spesso pesa da 2 a 10 GB). I modelli “medi”, molto adatti all’uso quotidiano, funzionano bene lì.
- Su Mac : Silicon Apple chip condividono la memoria tra CPU e grafica, rendendoli sorprendentemente efficienti per l’IA locale.
Per uso condiviso (team, SMB)
Quando più persone interrogano l’IA contemporaneamente, le esigenze aumentano:
- Una o più schede grafiche con 24 GB di VRAM o più, per modelli più potenti e richieste multiple simultanee.
- 64 GB di RAM o più, e un processore solido;
- Rapid storage (SSD) per i modelli e un NAS per i documenti RAG;
- Una macchina che è sempre accesa, quindi elettricità, rumore e raffreddamento sono da aspettarsi.
È proprio qui che l’approccio ibrido prende il suo valore: vita quotidiana a livello locale, compiti eccezionali nel cloud.
Per concludere in modo positivo: un’IA che si adatta a una chiavetta USB
Vuoi giocare? Portable Local Studio è uno studio AI “portatile” per Windows, Linux e macOS. Tutto ciò di cui ha bisogno è memorizzato in un’unica cartella, che puoi copiare su una chiavetta USB e portare ovunque. Nessuna installazione sul computer, nessuna connessione internet, nessuna chiave API.
Nel programma, in un’interfaccia grafica semplice:
- Discutere con template di testo (in formato GGUF, tramite llama.cpp);
- generare immagini con Stable Diffusion;
- dettare ad alta voce (riconoscimento vocale sussurrante);
- ascolta le risposte lette da una voce naturale (Kokoro).
L’applicazione rileva la tua scheda grafica (NVIDIA, AMD, Intel o chip Apple) per velocizzare i calcoli e mostra l’uso in tempo reale di CPU, memoria e scheda grafica. Senza scheda grafica, funziona anche, solo più lentamente. La dimostrazione video:
In conclusione
L’IA locale non è più riservata agli esperti. Con Ollama e Open WebUI, puoi iniziare in una sola sera. Con un NAS e pochi connettori, hai un assistente che conosce i tuoi documenti senza che esci di casa. E con l’ibrido, ottieni il meglio di entrambi i mondi, come dimostra Microsoft con Windows.
Una cosa è certa: l’IA è in continua evoluzione, quasi ogni settimana. Continueremo a seguire tutto questo da vicino e a tenervi informati, proprio qui, con lo stesso desiderio di rendere l’argomento semplice e accessibile. A presto!