Informatique & IAIntelligence artificielle
L'IA à la maison : reprenez les commandes de vos données
· Michel Aguilera
Lecture : 8 min · Pour curieux, débutants et bricoleurs du numérique
Quand vous posez une question à un assistant IA en ligne, votre texte part sur les serveurs d’une entreprise, quelque part dans le monde. Pratique, mais vous ne savez pas toujours ce qu’il devient. Et si l’IA tournait chez vous, sur votre ordinateur ou sur un petit serveur dans votre bureau ? C’est ce qu’on appelle l’IA en local. Bonne nouvelle : c’est beaucoup plus accessible qu’on ne le croit.
Pourquoi tout le monde parle de garder la main sur ses données
Imaginez que vous confiez vos documents à un secrétariat externe. Il fait du très bon travail, mais vos dossiers quittent votre bureau. Avec l’IA en ligne, c’est un peu pareil : vos questions, vos fichiers et vos idées passent par les serveurs d’un fournisseur.
De plus en plus de personnes et d’entreprises veulent savoir précisément ce que l’IA voit et exploite. Deux approches répondent à ce besoin :
- On-premise (« sur site ») : l’IA tourne entièrement sur votre matériel. Rien ne sort.
- Hybride : les tâches simples ou sensibles restent sur votre machine, et seules les tâches très lourdes partent dans le cloud (les gros serveurs en ligne).
L’approche hybride, c’est un peu comme cuisiner à la maison au quotidien et aller au restaurant pour les grandes occasions. Pour beaucoup, c’est la piste à privilégier.
Microsoft mise aussi sur l’« intelligence hybride »
Je ne suis pas le seul à le penser. Le 7 octobre 2026, Microsoft a présenté sa vision d’un Windows construit pour l’« hybrid intelligence » (intelligence hybride). Dans son billet, Pavan Davuluri, responsable de Windows, explique que les agents IA pourront tourner en local quand c’est pertinent et faire appel au cloud quand c’est nécessaire, grâce à un aiguillage automatique des tâches.
Ce qu’il faut retenir :
- Copilot sur Windows pourra, avec votre permission, utiliser le contexte de votre PC (vos fichiers, votre activité récente), agir pour vous et s’appuyer sur des modèles d’IA installés localement. Ces fonctions doivent arriver au cours des prochains mois.
- Microsoft Execution Containers (MXC) sont disponibles dès maintenant sur Windows 11. Ce sont des sortes de « bacs à sable » qui définissent à quels fichiers et à quels réseaux un agent IA a le droit d’accéder.
- De nouveaux PC conçus pour faire tourner l’IA localement arrivent, comme le Surface Laptop Ultra équipé d’une puce NVIDIA RTX Spark.
Autrement dit, même le géant de Redmond reconnaît que tout envoyer dans le cloud n’est pas toujours la meilleure idée. La présentation officielle de Microsoft :
Pour aller plus loin, deux vidéos (en anglais) de créateurs qui décortiquent ces annonces :
Source : Building Windows for hybrid intelligence, Windows Experience Blog
Démarrer simplement : Ollama et Open WebUI
Pas besoin d’être informaticien pour essayer l’IA en local. Deux outils gratuits font l’essentiel du travail :
- Ollama : c’est le « moteur ». Il télécharge et fait tourner des modèles d’IA (on les appelle des LLM, pour grands modèles de langage : des programmes entraînés à comprendre et écrire du texte). Une commande, et le modèle est prêt.
- Open WebUI : c’est la « carrosserie ». Une interface web qui ressemble à ChatGPT, mais qui discute avec les modèles installés chez vous.
Le moteur et la carrosserie, en somme : l’un fait le travail, l’autre le rend agréable à utiliser. Et si vous voulez aussi créer des images, Stable Diffusion s’ajoute facilement au duo.
J’ai réalisé une vidéo en français où je vous montre pas à pas l’installation et la découverte de ces outils :
Personnaliser : un NAS pour le RAG et des connecteurs de données
Un modèle d’IA, c’est un peu comme un brillant stagiaire qui a lu tout Internet… mais pas vos dossiers. Il ne connaît ni vos contrats, ni vos procédures internes, ni vos notes. C’est là qu’intervient le RAG.
Le RAG, expliqué simplement
RAG signifie Retrieval-Augmented Generation, soit « génération augmentée par la recherche ». Concrètement : avant de répondre, l’IA va chercher les passages utiles dans vos propres documents, puis s’en sert pour formuler sa réponse. C’est comme un stagiaire qui, avant de vous répondre, file consulter le bon classeur dans l’armoire.
Pour que cette recherche soit rapide, vos documents sont découpés en petits morceaux et rangés dans une base vectorielle : une sorte d’index intelligent qui retrouve les textes par le sens, et pas seulement par les mots exacts.
Pourquoi un NAS ?
Un NAS (Network Attached Storage) est un petit boîtier de stockage branché sur votre réseau, une sorte de disque dur partagé pour toute la maison ou le bureau. Beaucoup de gens y rangent déjà leurs documents. C’est donc l’armoire idéale pour le RAG : vos fichiers restent chez vous, et l’IA vient les consulter sur place. Open WebUI, par exemple, permet de créer des bases de connaissances à partir de vos documents.
Les connecteurs de données
Un connecteur, c’est un « tuyau » qui relie l’IA à une source d’information : un dossier du NAS, une base de données, une boîte mail, un agenda… Des outils comme n8n (un logiciel d’automatisation où l’on assemble des blocs, sans coder) permettent de créer ces tuyaux. Exemple : « chaque fois qu’un nouveau PDF arrive dans tel dossier, ajoute-le à la base de connaissances de l’IA ». Vous choisissez quelles sources sont branchées, et donc ce que l’IA a le droit de voir.
Des projets open source « tout-en-un », sans abonnement
Assembler soi-même chaque brique peut sembler intimidant. Heureusement, la communauté open source (des logiciels dont le code est public et gratuit) propose des packs prêts à l’emploi. Un bel exemple : Local AI Packaged, de Cole Medin.
Ce projet installe d’un coup tout un environnement d’IA locale, grâce à Docker (un outil qui fait tourner chaque logiciel dans sa propre « boîte », sans tout mélanger sur votre ordinateur). Au menu, selon son README :
- Ollama pour faire tourner les modèles d’IA ;
- Open WebUI pour discuter avec eux ;
- n8n pour les automatisations et les connecteurs (plus de 400 intégrations) ;
- Supabase pour la base de données, la recherche vectorielle et l’authentification ;
- Qdrant et Neo4j pour stocker et relier les connaissances ;
- Flowise pour construire des agents sans coder ;
- SearXNG, un moteur de recherche web qui ne vous piste pas ;
- Langfuse pour observer ce que font les agents, et Caddy pour sécuriser l’accès en HTTPS.
Des exemples de flux RAG prêts à importer sont même fournis. Voici à quoi ressemble n8n en action :
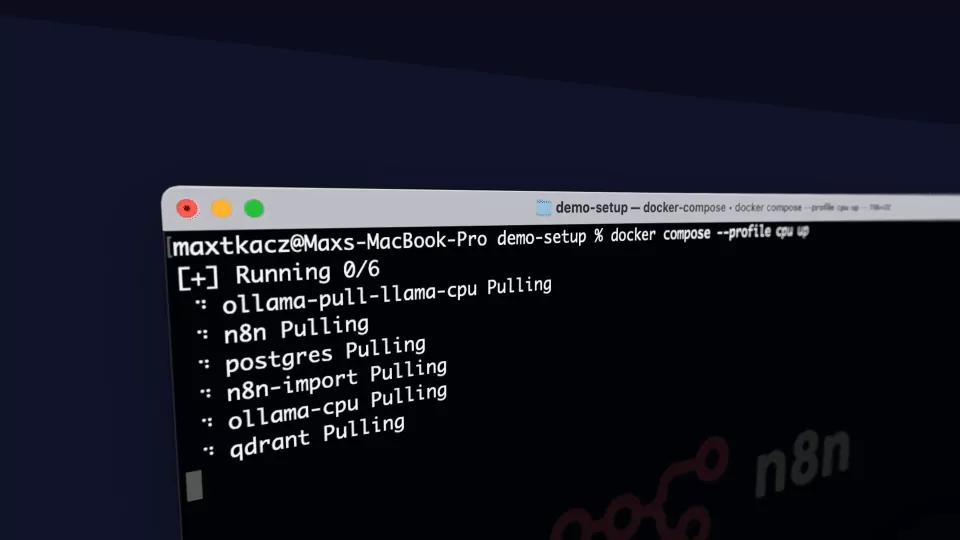
Tout cela sans payer d’abonnement : vous n’avez besoin que de votre matériel… et d’un peu de curiosité. Prérequis indiqués : Python, Git et Docker.
Le nerf de la guerre : le matériel
Soyons honnêtes : qui dit IA en local dit machine un peu musclée. Le composant clé est la carte graphique (GPU) et surtout sa mémoire vidéo (VRAM). Pensez à la VRAM comme au plan de travail d’une cuisine : plus il est grand, plus vous pouvez préparer de gros plats (de gros modèles) en même temps.
Les chiffres ci-dessous sont des ordres de grandeur indicatifs ; tout dépend des modèles choisis.
Pour un usage individuel
- Pour découvrir : un PC récent avec 16 Go de RAM peut faire tourner de petits modèles, même sans carte graphique dédiée. Ce sera lent, mais ça marche.
- Pour un usage confortable : une carte graphique avec 8 à 12 Go de VRAM, 32 Go de RAM et un SSD avec de la place (un modèle pèse souvent de 2 à 10 Go). Les modèles « moyens », très capables au quotidien, y tournent bien.
- Sur Mac : les puces Apple Silicon partagent leur mémoire entre processeur et graphique, ce qui les rend étonnamment efficaces pour l’IA locale.
Pour un usage partagé (équipe, PME)
Quand plusieurs personnes interrogent l’IA en même temps, les besoins grimpent :
- une ou plusieurs cartes graphiques de 24 Go de VRAM ou plus, pour des modèles plus puissants et plusieurs requêtes simultanées ;
- 64 Go de RAM ou plus, et un processeur solide ;
- du stockage rapide (SSD) pour les modèles, et un NAS pour les documents du RAG ;
- une machine allumée en permanence, donc à prévoir côté électricité, bruit et refroidissement.
C’est précisément là que l’approche hybride prend tout son sens : le quotidien en local, les tâches exceptionnelles dans le cloud.
Pour finir en beauté : une IA qui tient sur une clé USB
Envie de jouer ? Portable Local Studio est un studio d’IA « portable » pour Windows, Linux et macOS. Tout ce dont il a besoin est rangé dans un seul dossier, que vous pouvez copier sur une clé USB et emporter partout. Aucune installation sur l’ordinateur, aucune connexion Internet, aucune clé d’API.
Au programme, dans une interface graphique simple :
- discuter avec des modèles de texte (au format GGUF, via llama.cpp) ;
- générer des images avec Stable Diffusion ;
- dicter à voix haute (reconnaissance vocale Whisper) ;
- écouter les réponses lues par une voix naturelle (Kokoro).
L’application détecte votre carte graphique (NVIDIA, AMD, Intel ou puce Apple) pour accélérer les calculs, et affiche en direct l’utilisation du processeur, de la mémoire et de la carte graphique. Sans carte graphique, ça fonctionne aussi, simplement plus lentement. La démonstration en vidéo :
En conclusion
L’IA en local n’est plus réservée aux experts. Avec Ollama et Open WebUI, on démarre en une soirée. Avec un NAS et quelques connecteurs, on obtient un assistant qui connaît vos documents sans qu’ils quittent la maison. Et avec l’hybride, on profite du meilleur des deux mondes, comme le montre Microsoft avec Windows.
Une chose est sûre : l’IA évolue sans cesse, presque chaque semaine. Nous allons continuer à suivre tout cela de près et à vous tenir informés, ici même, avec la même envie de rendre le sujet simple et accessible. À très bientôt !